L’histoire de l’intelligence artificielle, des premières machines pensantes à ChatGPT
Publié par : Éloïse de Saint-Amans — Rédactrice spécialisée en tech
Relu, corrigé et validé par : Nathalie Durand — Rédactrice en chef
Quand l’intelligence artificielle est-elle née ?
L’idée d’une machine capable de raisonner est ancienne, mais l’IA moderne se construit au milieu du XXe siècle, à la croisée des mathématiques, de la logique, de l’informatique et des sciences cognitives. L’intelligence artificielle désigne un ensemble de méthodes qui permettent à une machine d’exécuter des tâches associées à certaines facultés humaines : apprendre, classer, planifier, comprendre ou produire du langage.
Le test de Turing pose une question décisive
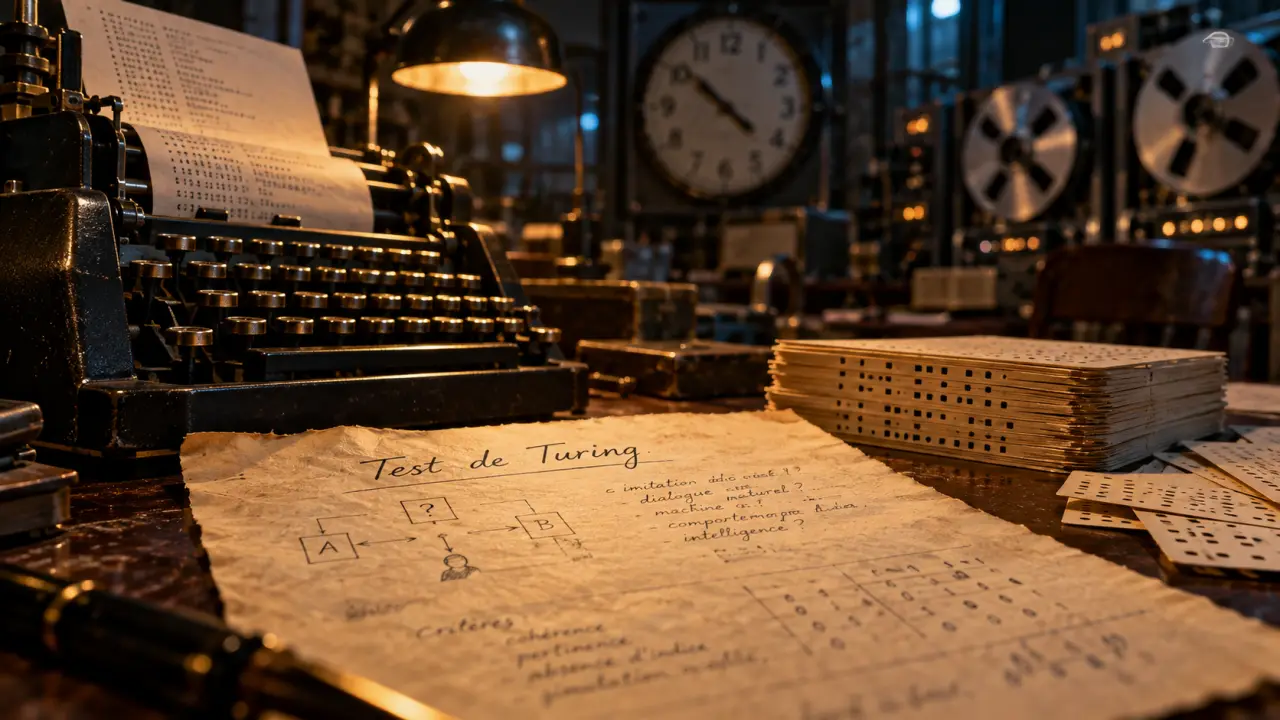
En 1950, Alan Turing publie Computing Machinery and Intelligence. Il déplace la question « une machine peut-elle penser ? » vers une approche observable : une machine peut-elle tenir une conversation au point de ne pas être distinguée d’un humain ? Ce jeu d’imitation, devenu le test de Turing, ne mesure pas toute l’intelligence. Il fournit néanmoins un cadre durable aux débats sur l’intelligence des machines et le traitement du langage naturel.
Les premières expérimentations s’inspirent déjà du fonctionnement cérébral. En 1951, le SNARC, pour Stochastic Neural Analog Reinforcement Calculator, simule un réseau de neurones. Ces travaux restent très limités par le matériel disponible, mais ils installent une idée importante : une machine peut modifier son comportement à partir de signaux et d’expériences.
Le terme « intelligence artificielle » apparaît en 1955
John McCarthy emploie l’expression dans la proposition du projet de Dartmouth, rédigée en 1955. L’atelier organisé l’année suivante réunit notamment Marvin Minsky, Claude Shannon et d’autres chercheurs. Leur ambition est vaste : décrire l’intelligence de manière assez précise pour la reproduire sur une machine. Cette rencontre est généralement considérée comme l’acte de naissance officiel du domaine.
Les repères qui racontent les grandes vagues de l’IA
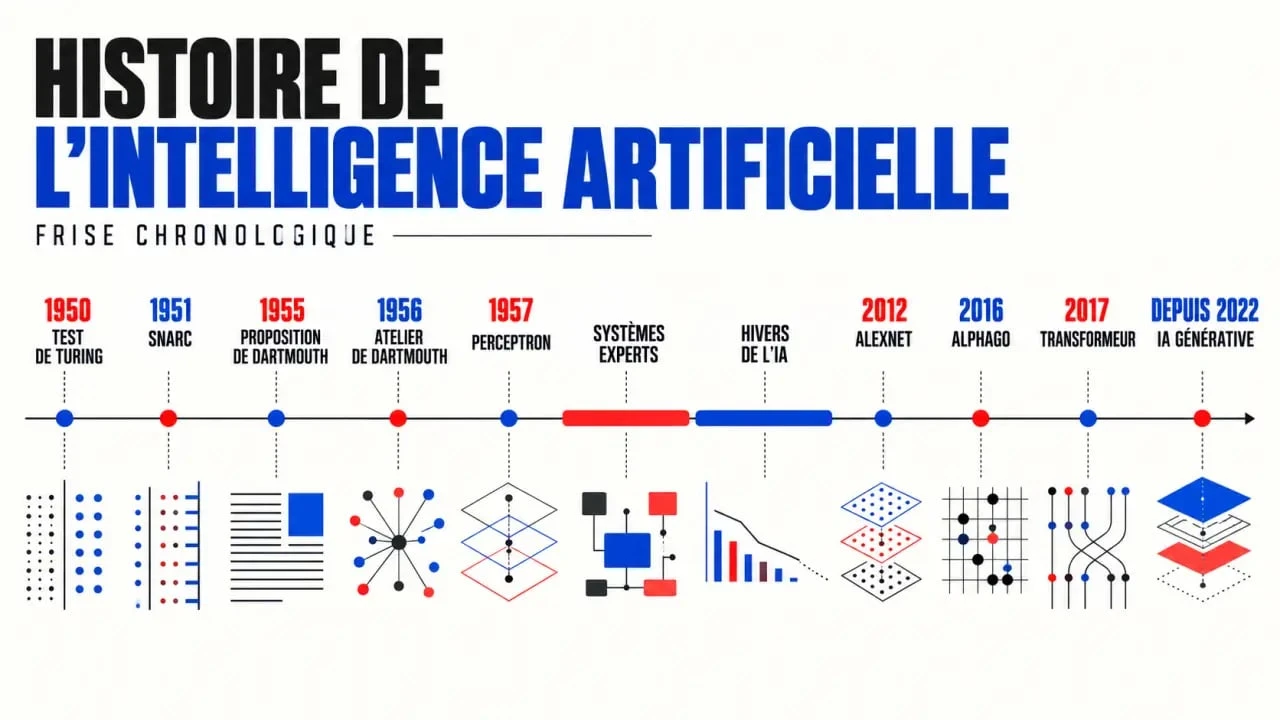
Une chronologie est utile, à condition de ne pas la lire comme une simple succession de dates. Chaque étape correspond à un changement de méthode, de ressources informatiques ou d’usage. L’histoire de l’IA alterne ainsi avancées, déceptions et nouveaux départs.
| Période | Rupture | Ce qu’elle change |
|---|---|---|
| 1950-1960 | Test de Turing, Dartmouth, perceptron | Les bases théoriques et les premiers modèles d’apprentissage sont posés. |
| 1960-1980 | IA symbolique et systèmes experts | La machine manipule des règles explicites pour résoudre des problèmes ciblés. |
| 1980-2000 | Retour des réseaux neuronaux | Le connexionnisme reprend place grâce à de meilleurs algorithmes d’apprentissage. |
| 2011-2017 | Deep learning, AlexNet, AlphaGo, transformeur | Les performances progressent fortement en vision, en jeu et en langage. |
| Depuis 2022 | Grands modèles de langage et IA multimodale | L’IA générative devient accessible dans les usages courants. |
En 1957, le perceptron illustre une première forme de réseau neuronal artificiel capable de distinguer des catégories simples. Dans les décennies suivantes, l’IA symbolique domine : les programmeurs formalisent des connaissances sous forme de règles du type « si… alors… ». Cette approche se révèle efficace dans des domaines étroits, notamment avec les systèmes experts. Elle devient cependant difficile à maintenir quand les situations sont ambiguës, variables ou trop nombreuses.
Les attentes démesurées et les limites techniques provoquent plusieurs « hivers de l’IA ». Les financements et l’intérêt diminuent lorsque les promesses ne se traduisent pas par des résultats robustes. Ces périodes expliquent pourquoi l’histoire de l’IA avance par cycles plutôt que selon une progression continue. Une méthode peut perdre de son influence, puis revenir lorsque les données, le matériel ou les algorithmes ont progressé.
Du raisonnement par règles à l’apprentissage par les données
L’IA symbolique et le connexionnisme ne résolvent pas les mêmes problèmes
L’IA symbolique représente des faits, des règles et des objectifs. Elle est pertinente lorsqu’il faut expliquer une décision ou appliquer une procédure stable. Le connexionnisme, lui, s’appuie sur des réseaux neuronaux artificiels : au lieu de recevoir toutes les règles à l’avance, le système ajuste ses paramètres à partir d’exemples. Cette différence éclaire les débats actuels : un modèle peut produire une réponse convaincante sans disposer d’un raisonnement explicite comparable à celui d’un système à règles.
Dans un système complexe, les règles explicites peuvent jouer le rôle de fusible : elles interrompent ou encadrent une action avant qu’une prédiction statistique ne devienne une décision risquée. L’histoire du domaine invite donc à combiner les approches plutôt qu’à les opposer. Pour contrôler un processus sensible, on peut associer apprentissage automatique, seuils de confiance, vérifications humaines et règles métier. La performance d’un modèle n’est qu’un élément d’une architecture de décision fiable.
Pourquoi le deep learning a relancé le domaine
Le renouveau des réseaux neuronaux s’accélère lorsque trois conditions se rencontrent : davantage de données numérisées, une puissance de calcul accrue et des méthodes d’entraînement plus efficaces. Le deep learning, ou apprentissage profond, empile plusieurs couches de neurones artificiels pour extraire progressivement des caractéristiques complexes. Le système peut ainsi repérer des régularités sans que chaque étape soit décrite manuellement par un programmeur.
Les jalons industriels rendent cette évolution visible. En 2011, Watson d’IBM gagne à Jeopardy!. En 2012, AlexNet marque la reconnaissance d’images en démontrant l’efficacité de réseaux neuronaux convolutifs entraînés à grande échelle. En 2016, AlphaGo, développé par DeepMind, bat le champion Lee Sedol au jeu de go en combinant réseaux neuronaux et apprentissage par renforcement profond. Ces réussites ne signifient pas qu’une intelligence générale a été atteinte : elles montrent surtout que des architectures spécialisées peuvent dépasser l’humain sur une tâche bien définie.
Pourquoi le transformeur a ouvert l’ère générative
Le transformeur, présenté en 2017, marque une rupture pour le traitement du langage naturel. Son mécanisme d’attention permet au modèle d’évaluer les relations entre les éléments d’une séquence, y compris lorsqu’ils sont éloignés. Cette capacité convient particulièrement au texte, où le sens d’un mot dépend souvent du reste de la phrase ou du document. Elle facilite aussi l’entraînement de modèles de grande taille.
Les grands modèles de langage sont entraînés à prédire la suite d’un texte à partir d’immenses corpus. Ils peuvent ensuite rédiger, résumer, traduire, programmer ou répondre à des questions. ChatGPT, apparu en 2022, a rendu cette famille de modèles immédiatement tangible pour le grand public. L’évolution ne tient pas uniquement à la qualité des réponses : l’interface conversationnelle a transformé une technologie de recherche en outil d’usage quotidien, accessible sans connaissances techniques particulières.
L’étape suivante est l’IA multimodale, capable de traiter plusieurs types de contenus, comme le texte, l’image, le son ou la vidéo. Elle rapproche des tâches autrefois séparées : décrire une image, analyser un document visuel, répondre oralement ou générer un contenu à partir d’instructions mêlant différents formats. Cette évolution prolonge la logique des modèles de langage tout en élargissant les informations qu’ils peuvent interpréter.
Les pionniers, les entreprises et la société façonnent ensemble l’IA
Réduire l’histoire de l’intelligence artificielle à quelques inventeurs serait trompeur. Alan Turing, John McCarthy, Marvin Minsky et Claude Shannon ont participé aux fondations. Plus tard, Geoffrey Hinton et Yann Le Cun comptent parmi les figures associées à la progression des réseaux neuronaux. Demis Hassabis et DeepMind incarnent le rapprochement entre recherche fondamentale et démonstrations très visibles.
Les laboratoires universitaires, les entreprises technologiques et les institutions publiques influencent désormais les orientations du secteur. Les besoins en données, en infrastructures de calcul et en compétences concentrent une partie du pouvoir technologique. Les politiques publiques abordent aussi la souveraineté numérique, la formation, le financement de la recherche et la diffusion de l’IA dans les services collectifs. Ces choix pèsent sur les technologies développées et sur les usages qui se généralisent.
Cette histoire conduit enfin à des questions qui dépassent la technique : biais dans les données, protection des droits d’auteur, confidentialité, consommation de ressources, désinformation, surveillance, sûreté des systèmes et usage militaire. Comprendre les étapes passées aide à prendre du recul face aux annonces actuelles. L’IA n’est ni une magie soudaine ni une invention isolée : c’est un domaine en évolution, dont les capacités et les limites dépendent autant des choix humains que des algorithmes.
- L’histoire de l’intelligence artificielle, des premières machines pensantes à ChatGPT - 30 septembre 2026
- Le marketing digital local attire des clients autour de chaque point de vente - 29 septembre 2026
- Design, innovation et créativité : trois rôles distincts pour concevoir une solution utile - 28 septembre 2026
Articles qui pourraient vous intéresser :
 Intraparis créer un compte : guide complet pour vous inscrire sans erreur
 Meilleur adaptateur bluetooth pour ampli hifi : le guide pour un son au top
 Apprendre, travailler, décrocher un diplôme reconnu : la formation développeur web en alternance
 Formation IA design : quels outils, quels formats et quels débouchés choisir ?